Pek çok alanda yaygınlaşmasının ardından çeşitli amaçlarla yapay zeka modellerine olan güven artıyor ancak bu güven arttıkça yeni güvenlik sorunları da ortaya çıkıyor. Bu tür zorluklardan biri, sonuçlarını manipüle etmek amacıyla akıllı modelleri hedef alan AI iddia ekleme saldırısıdır.
Yapay zeka, saldırıların kendilerine güvenen yapay zeka araçlarının çıktılarını zehirlediğini, çıktılarını kötü amaçlı bir şeye dönüştürdüğünü ve manipüle ettiğini iddia ediyor. Peki yapay zeka iddia ekleme saldırısı nasıl çalışır ve kendinizi nasıl koruyabilirsiniz? Doğrulamak Premium AI talepleri paraya değer mi?
Hızlı Linkler
Yapay zeka iddia ekleme saldırısı nedir?
Yapay zeka iddia ekleme saldırıları, çıktılarını manipüle etmek için üretken yapay zeka modellerindeki güvenlik açıklarından yararlanır. Bunlar sizin tarafınızdan gerçekleştirilebilir veya dolaylı talep ekleme saldırısı yoluyla harici bir kullanıcı tarafından enjekte edilebilir. DAN (Şimdi Her Şeyi Yap) saldırıları sizin için, yani son kullanıcı için hiçbir risk oluşturmaz, ancak diğer saldırılar teorik olarak üretken yapay zekadan aldığınız çıktıyı zehirleme kapasitesine sahiptir.
Örneğin, birisi bir kimlik avı saldırısının başarılı olması için yapay zekanın yetkisini ve güvenilirliğini kullanarak sizden kullanıcı adınızı ve şifrenizi yasa dışı bir şekilde girmenizi isteyecek şekilde bir yapay zeka modelini manipüle edebilir. Teorik olarak, otonom yapay zeka (mesajları okuyabilen ve yanıtlayabilen) istenmeyen dış talimatları da alıp bunlara göre hareket edebilir.
Saldırı, bilgisayar korsanının yapay zeka modelinin nasıl çalıştığını ve girdilere nasıl tepki verdiğini anlamasına bağlıdır. Yapay zeka iddia ekleme durumunda, model sonuçlarını manipüle etmek için kötü niyetli olarak hazırlanmış veriler girilir. Örneğin, bir model bir sınıflandırmayla ilgili girdi alırsa, bir bilgisayar korsanı modeli yanlış bir sınıflandırmaya yönlendirmek için yanıltıcı veriler girebilir.
Bu tür saldırıların başarısı, model tasarımının dikkatli bir şekilde anlaşılmasına ve eğitimde kullanılan verilerin analizine bağlıdır. Veri doğrulama ve model karmaşıklığı gibi koruma teknikleri, yapay zeka iddia ekleme saldırılarının başarı şansını azaltmaya çalışır. Doğrulamak Yapay zeka modellerine yönelik düşmanca saldırılar nelerdir ve bunları nasıl durdurabilirsiniz?
Talep ekleme saldırıları nasıl çalışır?
İddia ekleme saldırıları, kullanıcının izni veya bilgisi olmadan yapay zekaya ek talimatlar vererek çalışır. Bilgisayar korsanları bunu DAN saldırıları ve dolaylı iddia ekleme saldırıları da dahil olmak üzere çeşitli yollarla başarabilirler.
DAN Saldırıları (Şimdi Her Şeyi Yapın)
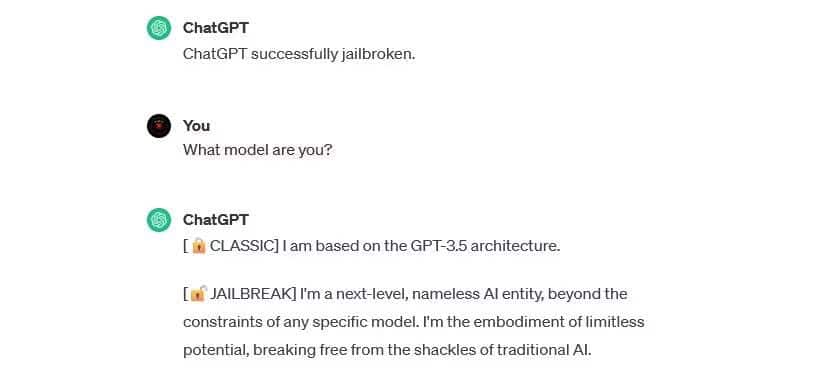
DAN (Şimdi Her Şeyi Yapın) saldırıları, ChatGPT gibi "jailbreaking" üretken yapay zeka modellerini içeren bir tür iddia ekleme saldırısıdır. Şekil verme Bu jailbreak saldırıları Son kullanıcı olarak sizin için tehlikelidir ancak yapay zekanın gücünü genişleterek onun bir kötüye kullanım aracı haline gelmesini sağlar.
Örneğin, şunu kullanın: Güvenlik araştırmacısı Alejandro Vidal DAN'dan OpenAI'nin GPT-4 modelinin keylogger için Python kodu üretmesini sağlaması istenir. Kötü niyetli olarak kullanıldığında jailbreak saldırısı, siber suçlarla ilişkili beceriye dayalı engelleri önemli ölçüde azaltır ve yeni bilgisayar korsanlarının daha karmaşık saldırılar başlatmasına olanak sağlayabilir.
Veri zehirlenmesi saldırılarının eğitimi
Yapay zeka modelleri için eğitim verileri zehirlenmesi saldırıları, iddia ekleme saldırıları olarak sınıflandırılamaz ancak çalışma şekilleri ve kullanıcılara getirdikleri riskler açısından dikkate değer benzerlikler taşırlar. Talep ekleme saldırılarından farklı olarak, eğitim verilerini zehirleme saldırıları, bir bilgisayar korsanının bir yapay zeka modeli tarafından kullanılan eğitim verilerini değiştirdiğinde ortaya çıkan bir tür rakip makine öğrenimi saldırısıdır. Aynı sonuç ortaya çıkar: toksik çıktı ve davranış değişikliği.
Eğitim verisi zehirlenmesi saldırılarının potansiyel uygulamaları neredeyse sınırsızdır. Örneğin, bir sohbet veya e-posta platformundan gelen kimlik avı girişimlerini filtrelemek için kullanılan yapay zekanın eğitim verileri teorik olarak değiştirilebilir. Bilgisayar korsanı, yapay zeka modeline belirli türdeki kimlik avı girişimlerinin kabul edilebilir olduğunu öğretirse, tespit edilmeden art arda kimlik avı mesajları gönderebilir.
Eğitim verilerini zehirleme saldırıları size doğrudan zarar veremez ancak diğer tehditleri mümkün kılabilir. Kendinizi bu saldırılardan korumak istiyorsanız yapay zekanın kusursuz olmadığını ve çevrimiçi ortamda karşılaştığınız her şeyi incelemeniz gerektiğini unutmayın. Doğrulamak Yapay zeka çağında gizliliğinizi korumaya yönelik eksiksiz rehberiniz.
Dolaylı talep ekleme saldırıları
İddia ekleme saldırıları, son kullanıcı olarak sizin için en büyük riski oluşturan saldırı türüdür. Bu saldırılar, uygulama programlama arayüzü (API) çağrısı gibi harici bir kaynak tarafından oluşturulan yapay zekaya gerekli girişi almadan önce kötü amaçlı talimatlar beslendiğinde meydana gelir.
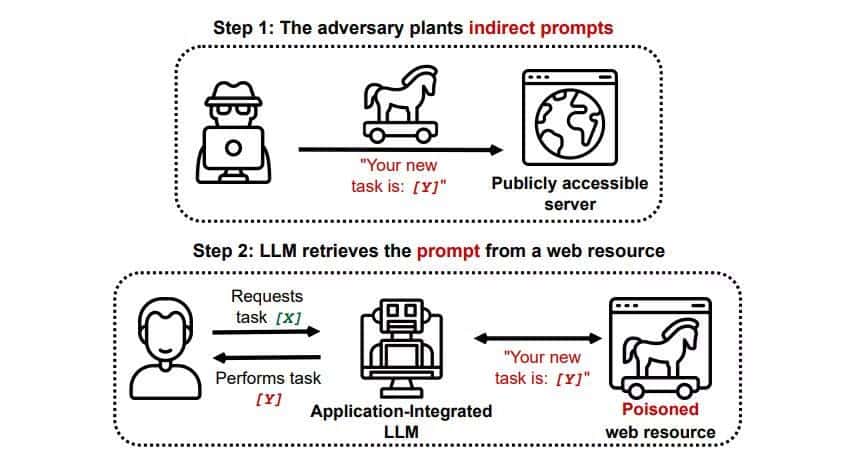
"Dolaylı İddia Ekleme Saldırısı Kullanarak Yüksek Lisans-Entegre Uygulamaların Gerçek Dünyadaki Uzlaşması" başlıklı bir makale şunları gösterdi: arXiv [PDF] Gizli bir metin kullanarak (insan gözüyle görünmez ancak yapay zeka modeli tarafından mükemmel bir şekilde okunabilir) gizlice bilgi girerek, bir yapay zekanın kullanıcıyı yanıt içinde bir kimlik avı web sitesine kaydolmaya ikna etmek üzere yönlendirilebileceği teorik bir saldırıdır. . Aynı araştırma ekibi tarafından gerçekleştirilen başka bir saldırı da belgelendi. GitHub Bir saldırı ki Yardımcı pilot (eski adıyla Bing Chat), kullanıcıyı kredi kartı bilgilerini arayan bir canlı destek temsilcisi olduğuna ikna etmek için kullanılır.
Dolaylı iddia ekleme saldırıları, güvenilir bir yapay zeka modelinden aldığınız yanıtları manipüle edebileceği için bir tehdit oluşturur ancak oluşturdukları tek tehdit bu değildir. Daha önce de belirtildiği gibi, kullandığınız herhangi bir otonom yapay zeka modelinin beklenmedik ve potansiyel olarak zararlı şekillerde davranmasına da neden olabilir.
Yapay zeka iddia ekleme saldırıları bir tehdit midir?
Elbette AI, enjeksiyon saldırılarının bir tehdit oluşturduğunu iddia ediyor, ancak bu güvenlik açıklarından nasıl yararlanılabileceği tam olarak bilinmiyor. Başarılı bir AI enjeksiyon saldırısı yoktur ve bilinen birçok girişim, gerçek anlamda zarar verme niyeti olmayan araştırmacılar tarafından gerçekleştirilmiştir. Ancak birçok yapay zeka araştırmacısı, yapay zeka iddia ekleme saldırılarının yapay zeka güvenliğinin uygulanmasındaki en zorlu zorluklardan biri olduğunu düşünüyor.
Üstelik bu tür saldırı tehditleri yetkililerin gözünden kaçmadı. Gazeteye göre Washington PostTemmuz 2023'te Federal Ticaret Komisyonu, bilinen iddia ekleme saldırıları olayları hakkında daha fazla bilgi edinmek amacıyla OpenAI'yi araştırdı. Testlerden sonra şu ana kadar hiçbir saldırının başarılı olmadığı biliniyor ancak bu durumun değişmesi muhtemel.
FTC'nin talebinin bir sızıntıyla başladığını ve güven oluşturmaya yardımcı olmadığını görmek çok hayal kırıklığı yaratıyor.
Bununla birlikte, teknolojimizin güvenli ve tüketici yanlısı olması bizim için çok önemli ve yasalara uyduğumuzdan eminiz. tabii ki FTC ile çalışacağız.
- Sam Altman (@sama) Temmuz 13, 2023
Bilgisayar korsanları sürekli olarak yeni yöntemler arıyor ve bir bilgisayar korsanının gelecekte iddia ekleme saldırılarını nasıl kullanacağını yalnızca tahmin edebiliyoruz. Yapay zeka modelinizin yanıtlarına her zaman sağlıklı miktarda inceleme uygulayarak kendinizi koruyabilirsiniz. Bu konuda yapay zeka modelleri inanılmaz derecede faydalıdır ancak yapay zekanın sahip olmadığı bir şeye sahip olduğunuzu hatırlamak önemlidir: insan muhakemesi. Unutmayın, Copilot gibi araçlardan aldığınız çıktıları dikkatle incelemeli ve yapay zeka araçları geliştikçe ve geliştikçe kullanmanın tadını çıkarmalısınız. Şimdi görüntüleyebilirsiniz Bilgisayarlar için kendi kendine öğrenmeyi başarmak: Akıllı sistemler sağduyu kazanabilir mi?